Reverse Proxies verstehen: Routing, TLS und Sicherheit
Ein Blog, eine Cloud und vielleicht noch ein Dashboard: Beim Selfhosting möchte man diese Dienste meistens unter normalen Domainnamen erreichen. Der Browser soll weder interne Portnummern kennen noch wissen müssen, auf welchem Server die jeweilige Anwendung läuft.
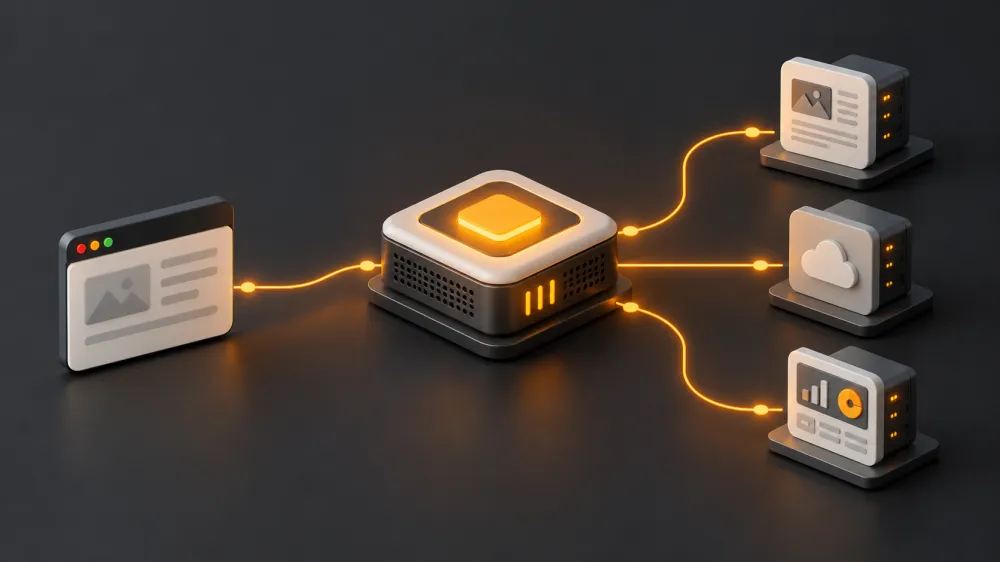
Ein Reverse Proxy kann diese Zuordnung übernehmen. Er nimmt Verbindungen entgegen und vermittelt Anfragen an passende Dienste. Wobei „vermitteln“ erstmal wenig darüber sagt, wo HTTPS endet oder welche Informationen die Anwendung später sieht. Genau dort entstehen viele Konfigurationsfehler.
Was an einem Proxy eigentlich „reverse“ ist
Ein Proxy ist ein Vermittler. Ein Forward Proxy wird aus Sicht der Clients eingesetzt: beispielsweise als konfigurierter Ausgangspunkt für deren Webzugriffe. Ein Reverse Proxy steht vor Diensten und übernimmt aus Sicht der Besucher die Rolle des Servers. Diese Unterscheidung beschreibt RFC 9110 bei Proxies und Gateways.
Der Browser verbindet sich also mit dem Reverse Proxy. Die Anwendung dahinter heißt häufig Backend oder Upstream. Upstream bezeichnet das Ziel, an das der Proxy die Anfrage weitergibt; das muss keine einzelne Maschine sein.
Ein normaler Webserver kann Inhalte auch direkt ausliefern und zugleich für bestimmte Anfragen als Reverse Proxy arbeiten. Nginx, Caddy und Traefik sind mögliche Implementierungen, aber die Architektur hängt nicht an einem bestimmten Produkt.
Video-Einstieg: Das folgende Video von U-Labs zeigt die Grundidee grafisch anhand klassischer Webserver mitsamt Docker.
Der Artikel ergänzt den Einstieg um Routing, TLS-Verbindungen und die Vertrauensgrenzen bei weitergereichten Headern.
Zwei Domains, dieselbe Adresse, unterschiedliche Anwendungen
Für ein bewusst einfaches Beispiel zeigen beide Namen auf die erreichbare Adresse des Proxys:
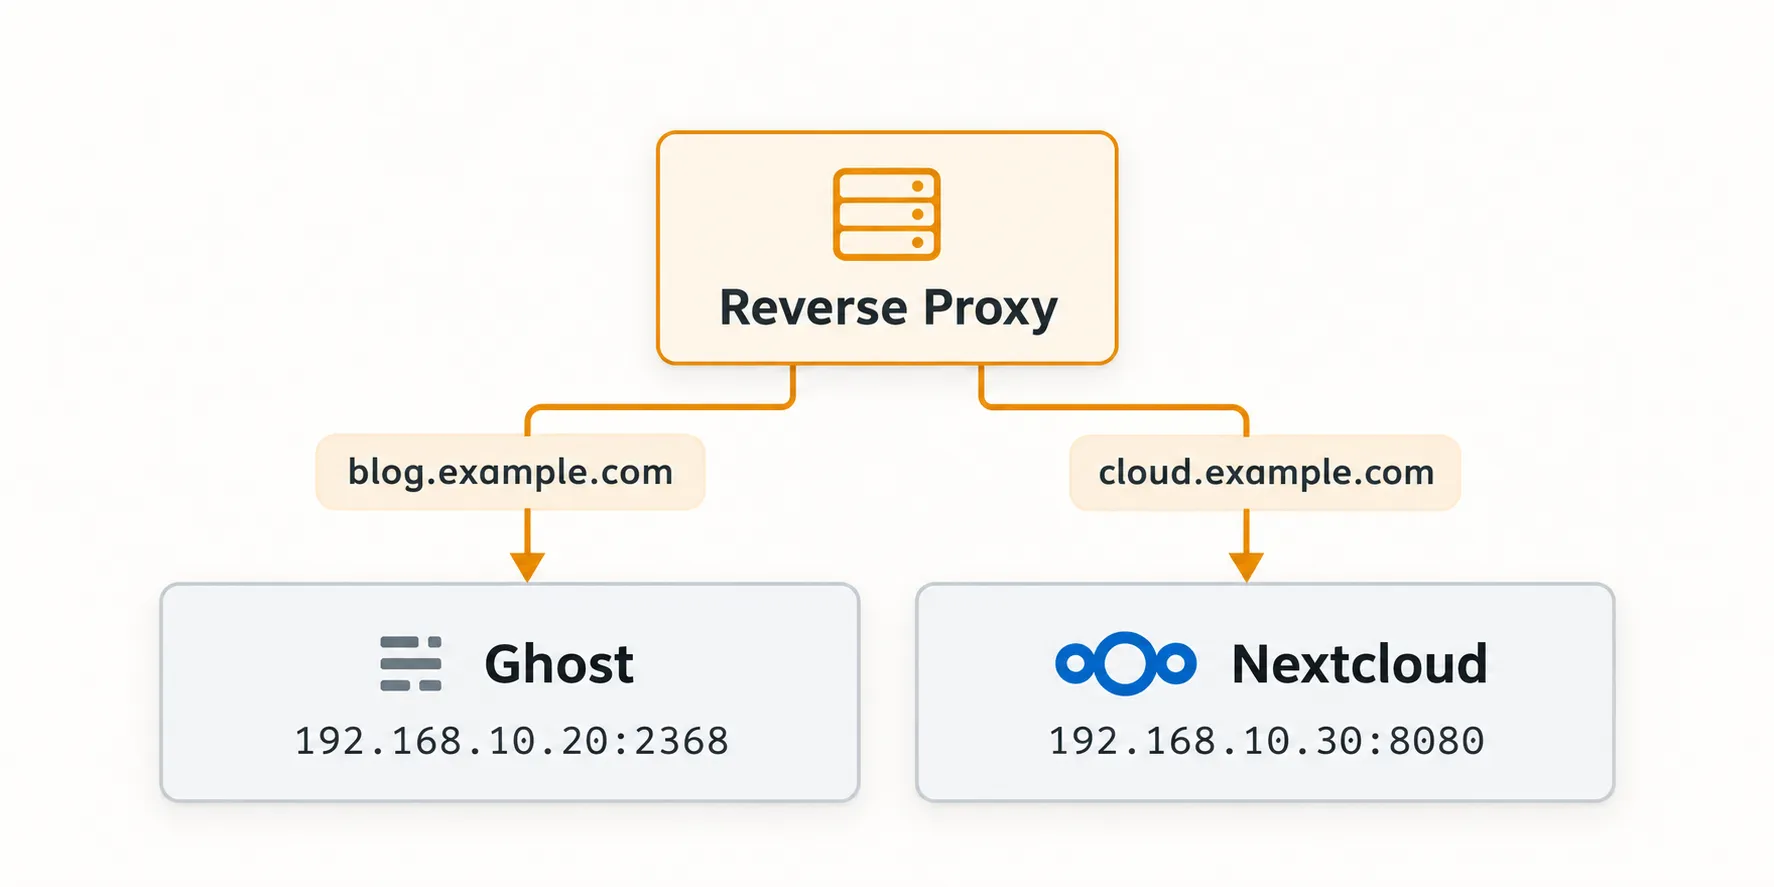
Diese Adressen sind natürlich nur ein Beispiel. DNS erledigt die Namensauflösung. Die Routingregel im Proxy entscheidet anschließend, welcher Dienst die Anfrage bekommt. Ein DNS-Eintrag allein erzeugt diese Weiterleitung nicht.
Der gemeinsame Einstieg kann Port 443 verwenden. Die internen Dienste dürfen auf anderen Adressen und Ports lauschen. Eine Portnummer kennzeichnet dabei den angesprochenen Transportendpunkt; sie ist nicht selbst die Identität der Website.
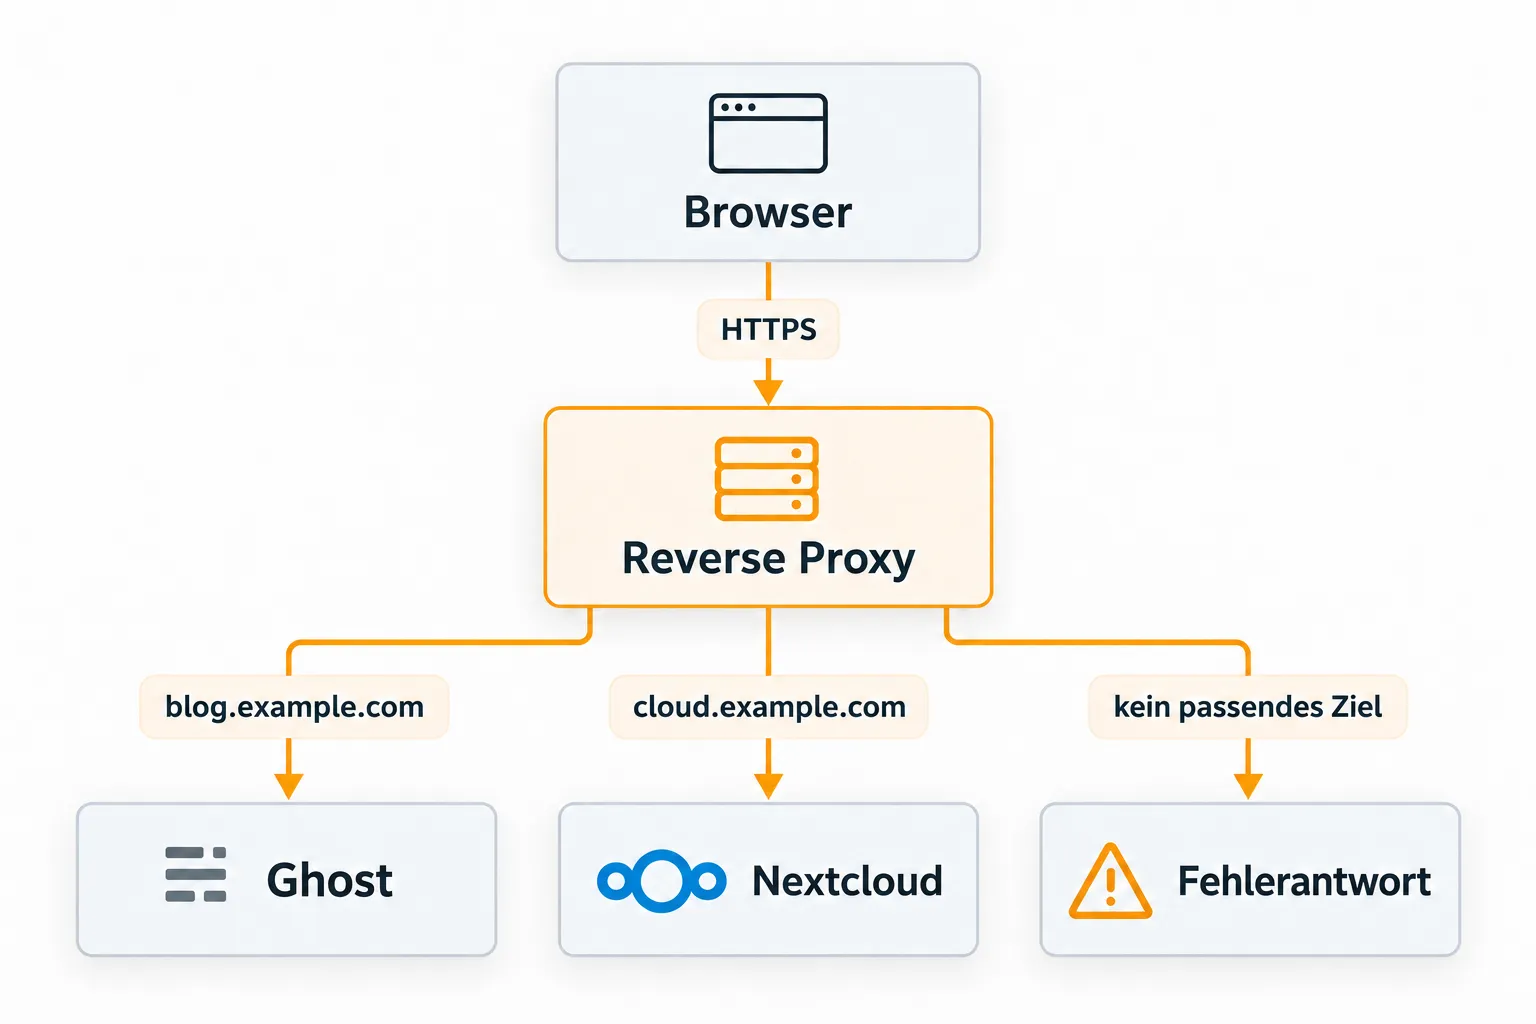
Die Grafik zeigt die Auswahl der Anwendung. Sie legt noch nicht fest, ob die Backend-Verbindungen HTTP oder HTTPS verwenden.
Ein Reverse Proxy ist dafür praktisch, aber nicht zwingend erforderlich. Ein Webserver kann selbst mehrere virtuelle Hosts und HTTPS bedienen. Der Proxy lohnt sich besonders, wenn Anwendungen getrennt betrieben werden und man ihren öffentlichen Einstieg gemeinsam verwalten möchte.
SNI beim TLS-Aufbau, Hostnamenrouting bei HTTP
Beim HTTPS-Aufbau muss der Server seine TLS-Konfiguration auswählen, bevor er eine verschlüsselte HTTP-Anfrage lesen kann. Dafür liefert der Client üblicherweise den Namen über SNI im TLS-ClientHello. RFC 6066 beschreibt diese Erweiterung. ClientHello ist der technische Name der ersten Nachricht, mit der der Client den TLS-Verbindungsaufbau einleitet.
Nach der TLS-Terminierung kann ein HTTP-Proxy die Anfrage lesen. Für Hostnamenrouting verwendet er die HTTP-Zielinformation, bei HTTP/1.1 etwa Host, bei HTTP/2 und HTTP/3 insbesondere :authority. Auch der Pfad kann als Routingkriterium dienen.
SNI und HTTP-Hostname sind damit Angaben auf unterschiedlichen Ebenen. Man sollte nicht annehmen, dass sie in jeder denkbaren Anfrage automatisch übereinstimmen. Die Konfiguration muss bestimmen, welche Kombinationen akzeptiert werden.
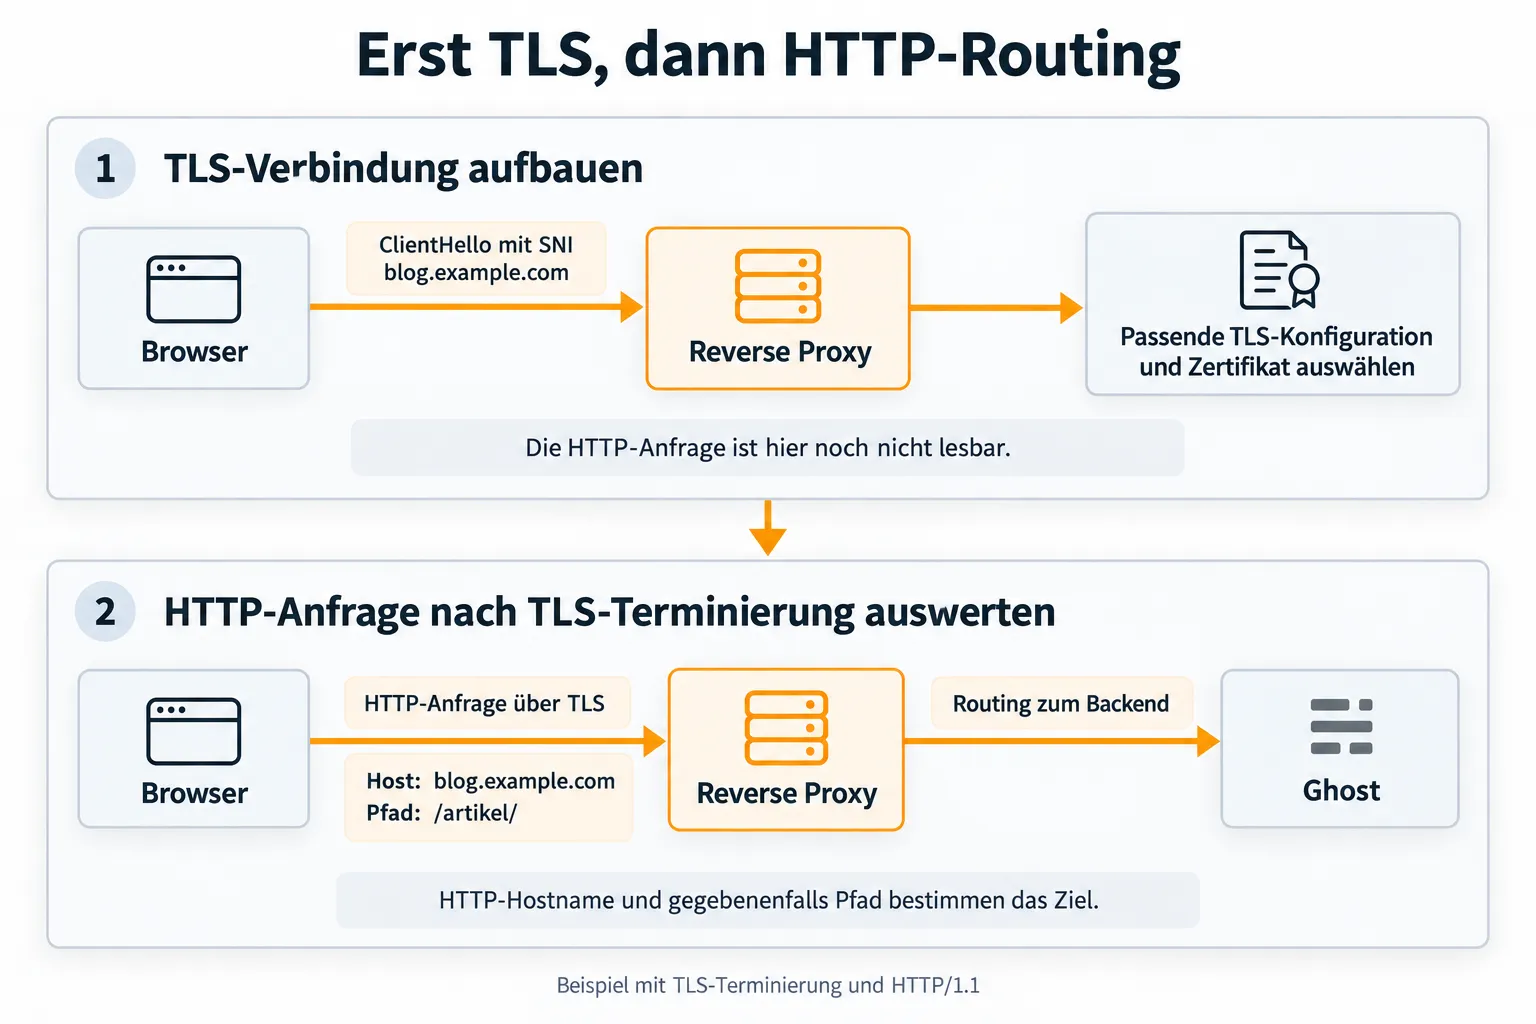
SNI (Server Name Indication): Der Browser nennt beim TLS-Aufbau den gewünschten Hostnamen. So kann der Server oder Reverse Proxy das passende Zertifikat auswählen.
HTTP (Hypertext Transfer Protocol): Protokoll für die Kommunikation zwischen Browser und Webserver. Ohne zusätzliche Verschlüsselung können die übertragenen Inhalte mitgelesen werden.
HTTPS (Hypertext Transfer Protocol Secure): Überträgt HTTP verschlüsselt über TLS und prüft die Identität des Servers anhand seines Zertifikats.
Beim Pfadrouting könnte derselbe Name /blog/ und /cloud/ auf verschiedene Backends verteilen. Das klingt einfach, ist für Anwendungen aber nicht immer problemlos: Verweise, Weiterleitungen und Cookies müssen zur gewünschten Basis-URL passen. Das bloße Entfernen eines Präfixes im Proxy garantiert diese Unterstützung nicht.
Drei unterschiedliche Wege für TLS
Die wichtigste Frage ist, welche Komponenten tatsächlich TLS-Endpunkte sind:
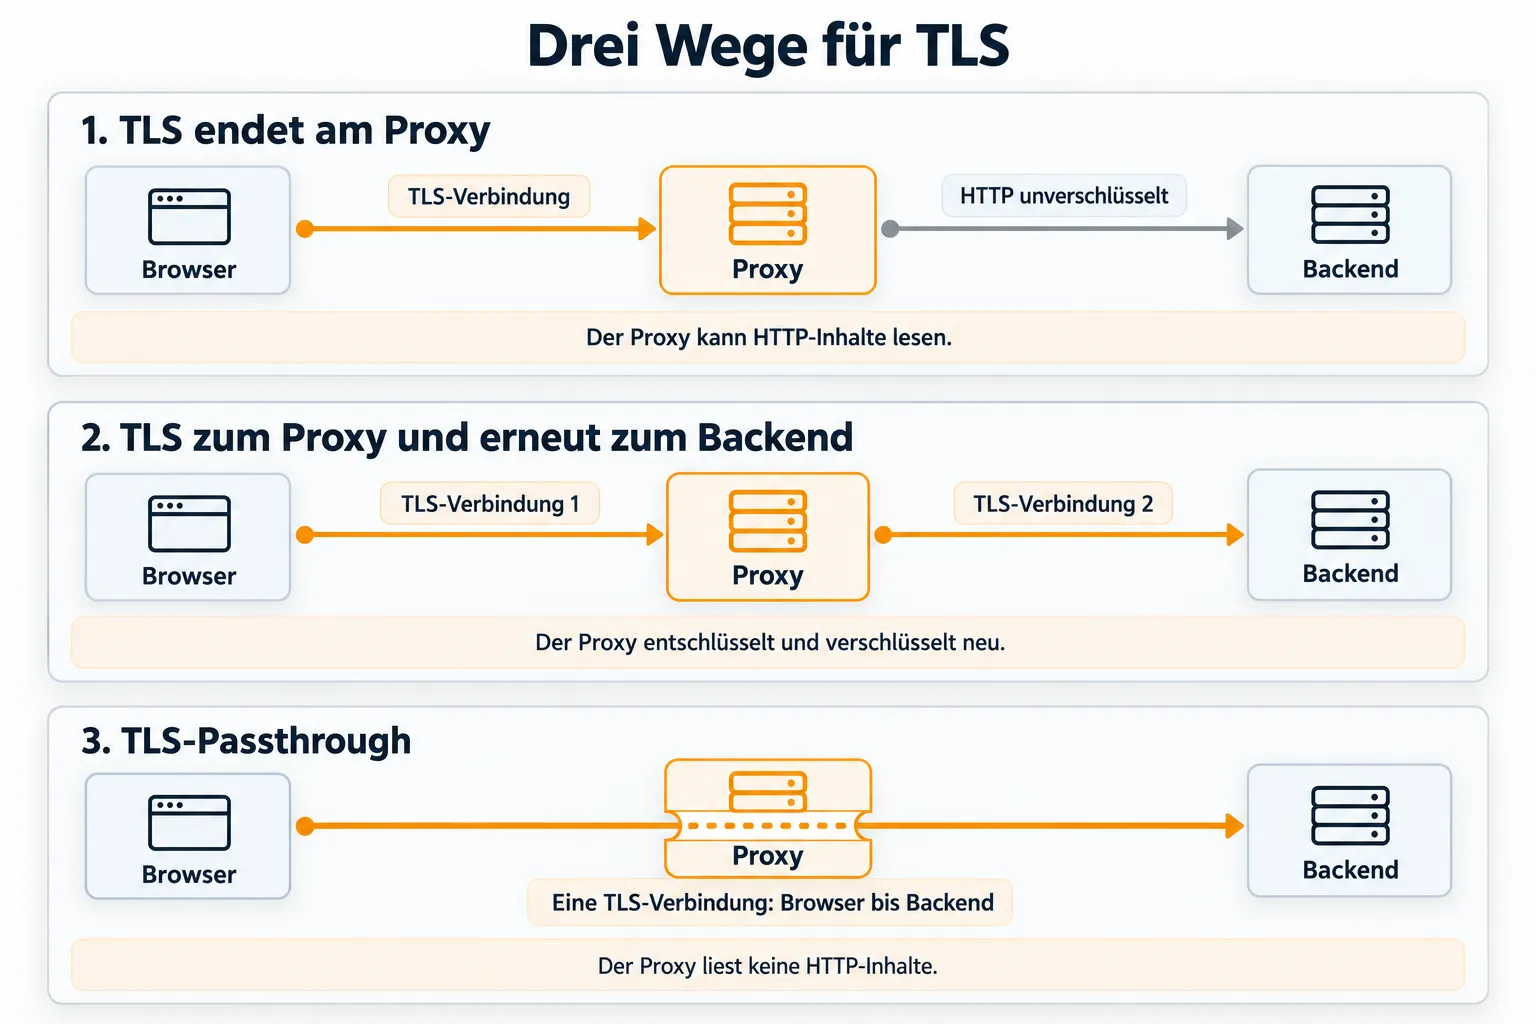
Bei Termination kann der Proxy HTTP-Inhalte lesen und bearbeiten. Er benötigt Zugriff auf den passenden privaten Schlüssel. Der Browser prüft das Zertifikat dieses Einstiegspunkts, nicht automatisch das eines dahinterliegenden Dienstes.
Bei erneutem HTTPS zum Upstream gibt es zwei voneinander getrennte TLS-Verbindungen. Der Proxy kann den Inhalt dazwischen weiterhin lesen. Außerdem muss er die Backend-Identität sinnvoll prüfen: passende Vertrauensbasis, Name und Zertifikat. „Zum Backend auch HTTPS“ beantwortet diese Konfigurationsfragen noch nicht.
Bei Passthrough bleiben die HTTP-Inhalte für einen reinen TCP-Vermittler verschlüsselt. Er kann deshalb keine HTTP-Pfade auswerten oder HTTP-Header umschreiben. Routing anhand sichtbarer TLS-Informationen wie SNI ist möglich, sofern diese verfügbar sind. ECH kann den inneren Namen verbergen; eine Architektur darf daher nicht universell auf dessen Sichtbarkeit bauen.
Traefik dokumentiert TLS-Passthrough für TCP-Router. Das ist keine Einstellung, mit der ein HTTP-Router zugleich verschlüsselte Inhalte durchreichen und deren Pfade lesen könnte.
Warum das Backend häufig die IP des Proxys sieht
Bei einem HTTP-Reverse-Proxy sind eingehende und ausgehende Verbindungen getrennt. Am Backend ist deshalb normalerweise der Proxy der direkte Verbindungspartner. Damit Informationen über den ursprünglichen Zugriff erhalten bleiben, werden häufig zusätzliche Header verwendet.
Forwarded kann beispielsweise Clientadresse, ursprünglichen Host und Schema übertragen. Daneben sind X-Forwarded-For, X-Forwarded-Host und X-Forwarded-Proto verbreitet. RFC 7239 definiert Forwarded und seine Vertrauensgrenzen.
Wenn außen HTTPS verwendet wird, innen aber HTTP, muss die Anwendung diesen Unterschied kennen. Sonst erzeugt sie unter Umständen falsche URLs oder Weiterleitungen. Welche Header ausgewertet werden, hängt von der Anwendung ab.
Der ursprüngliche Host wird ebenfalls nicht von jedem Produkt in jeder Konfiguration automatisch unverändert übertragen. Die Nginx-Dokumentation zeigt die explizite Anpassung von Proxy-Headern. Bei solchen Einstellungen müssen Backend-Anforderungen und eingesetzte Version zusammenpassen.
Ein Client-IP-Header ist zunächst nur eine Behauptung
Ein Besucher kann selbst X-Forwarded-For mitsenden. Wenn die Anwendung blind den ersten Wert übernimmt, kann sie eine frei erfundene Adresse protokollieren oder für Zugriffskontrollen verwenden.
An der äußeren Vertrauensgrenze muss deshalb feststehen, welche Werte neu gesetzt und welche nur von bekannten vorgeschalteten Proxies übernommen werden. Die Anwendung wiederum darf diese Informationen nur von ihren vorgesehenen Proxy-Zugängen akzeptieren. Bei mehreren Vermittlern braucht es eine konsistente Regel für die gesamte Kette.
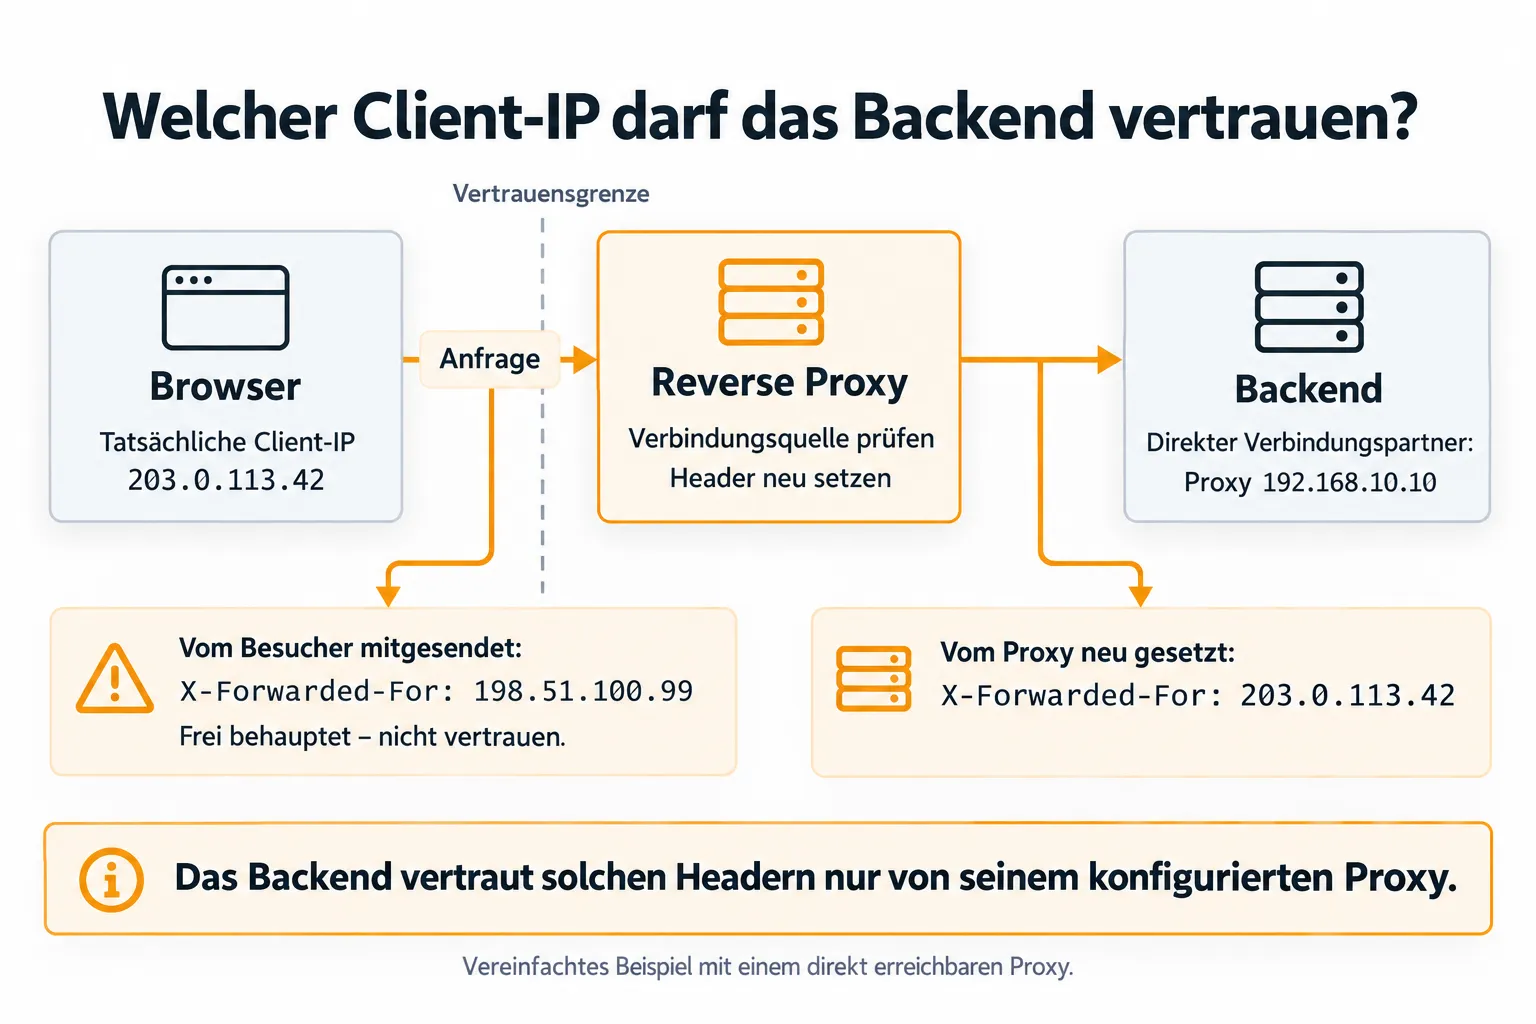
Caddy beschreibt sein Verhalten für Forwarding-Header und vertrauenswürdige Proxies: Eingehende Werte werden standardmäßig nicht einfach als vertrauenswürdig übernommen. Solche Produktvorgaben sind hilfreich, ersetzen aber keine Prüfung der eigenen Topologie.
Für TCP-Passthrough werden Clientinformationen gegebenenfalls über andere Mechanismen weitergegeben, etwa PROXY Protocol. Das ist kein HTTP-Header und setzt Unterstützung sowie eine passende Vertrauenskonfiguration auf beiden Seiten voraus. Für das Grundverständnis genügt hier: Die Client-IP bleibt nicht in jeder Vermittlungsarchitektur automatisch erhalten.
Was der gemeinsame Einstieg erleichtert – und was er offenlässt
Die Begriffe bezeichnen unterschiedliche Dinge: Reverse Proxy beschreibt die Rolle vor den Backends; Load Balancing die Verteilung des Verkehrs auf mehrere Upstreams. Ein HTTP-Reverse-Proxy kann als Layer-7-Load-Balancer HTTP-Anfragen verteilen. Layer-4-Load-Balancing verteilt TCP- oder UDP-Verbindungen, ohne HTTP-Pfade oder Header auszuwerten. NGINX dokumentiert beide Varianten.
Load Balancing ist eine mögliche Erweiterung, keine notwendige Eigenschaft jedes Reverse Proxys. Zustand, Sitzungen und Ausfallverhalten müssen dabei zur Anwendung passen.
Der gemeinsame Einstieg erlaubt außerdem, Backend-Ports auf ein internes Netz zu beschränken. Aber ein intern laufender Dienst kann über die Proxyroute weiterhin öffentlich erreichbar sein. Die private IP ist also keine Zugriffsregel für Besucher.
Ob zwischen Proxy und Backend HTTP genügt, hängt von der Vertrauensgrenze ab. Ein lokaler Unix-Socket hat andere Rahmenbedingungen als eine Verbindung über ein fremdes Netz. Bei TLS zum Backend gehört eine funktionierende Identitätsprüfung dazu. mTLS kann zusätzlich den Proxy gegenüber dem Backend authentifizieren; komplexe Kombinationen verdienen einen eigenen Artikel.
Für eine nachvollziehbare Konfiguration würde ich deshalb zuerst den Datenweg aufzeichnen: Wo endet TLS? Wer darf das Backend erreichen? Welche Identität wird geprüft? Welchen Headern darf die Anwendung vertrauen? Erst wenn diese Fragen beantwortet sind, wird aus einem funktionierenden Routing auch eine verständliche Architektur.
Fazit
Ein Reverse Proxy ist nur einer von vielen Bausteinen, die dafür sorgen, dass moderne Webdienste zuverlässig und sicher erreichbar sind. In weiteren Artikeln werden wir uns unter anderem genauer mit HTTPS, TLS und digitalen Zertifikaten beschäftigen.
Wenn dir dieser Artikel gefallen hat und du mehr über die Technik hinter unseren alltäglichen Anwendungen erfahren möchtest, würde ich mich freuen, wenn du DriftWare.io abonnierst oder den Artikel mit anderen teilst.